Dubletten
AS MearchBox Anwendungen
Die AS MearchBox kommt in vier Anwendungen zum Einsatz: Online-Suche, Eingabekontrolle, Dublettenidentifikation und Referenzmatch.
Die Online-Suche
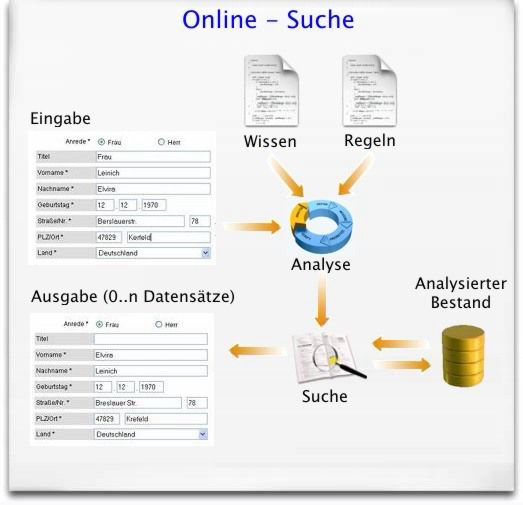
Ein Kernproblem in den heutigen Applikationen und Systemen sind die oft mangelhaften Suchmechanismen. Entweder werden nicht alle gesuchten Datensätze gefunden (Underkill), oder die Suche liefert zu viele nicht interessierende Ergebnisse (Overkill), durch die dann umständlich und zeitintensiv geblättert werden muss.
Merkmal der fehlertoleranten, intelligenten und treffsicheren Online-Suche mit der AS MearchBox ist die Suche mit einigen wenigen, oft auch verstümmelten, fehlerbehafteten, aber ähnlichen Eingaben. Die Suche liefert die in Frage kommenden Datensätze aus dem Bestand nach der Höhe der Ähnlichkeit sortiert.
Die Eingabekontrolle
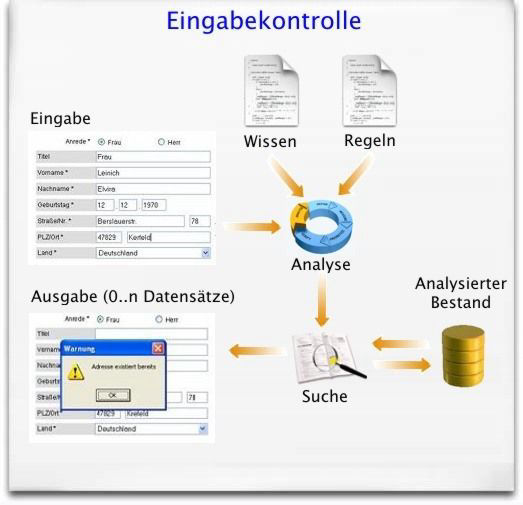
Hier handelt es sich um eine der Online-Suche sehr ähnliche Anwendung einer Identifikationssoftware. Ziel ist es, eine Neueingabe vor der Speicherung zuerst im Bestand zu suchen und vor möglichen, bereits vorhandenen Einträgen der gleichen Person oder Organisation zu warnen, um online die Erzeugung neuer Dubletten zu verhindern.
Die hier beschriebene Eingabekontrolle ist also ein Online-Dublettencheck.
Die Dublettenidentifikation
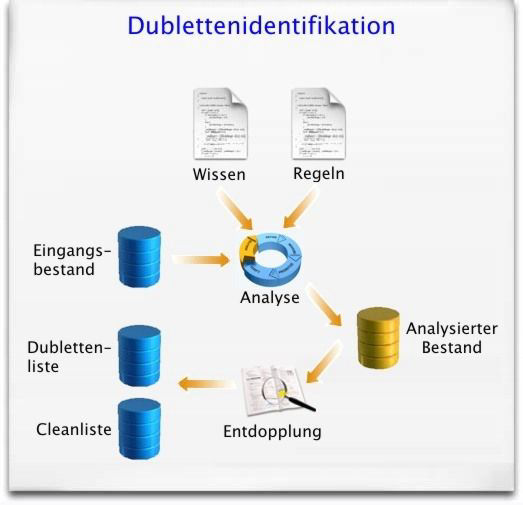
Bei einer Dublettenidentifikation geht es darum, alle sicheren und potentiellen Dubletten innerhalb eines Bestandes zu identifizieren.
Dabei wird prinzipiell jeder Datensatz mit den jeweils anderen sukzessive verglichen. Bei genügend hoher, frei definierbarer Ähnlichkeit wird das entsprechende Vergleichspaar in eine Ergebnisdatei oder Tabelle geschrieben.
Neben dieser paarweisen Sicht werden automatisch weitere Ergebnisse generiert, sodass eine Analyse und Integration der Ergebnisse optimal unterstützt wird:
- Gruppensichten: Alle miteinander korrelierenden Datensätze erhalten die gleiche Gruppennummer.
- Eyecatcher: die Kopfdublette einer Dublettengruppe, die nach verschiedenen Verfahren ermittelt werden kann.
- Cleanliste: alle Kopfdubletten zzgl. der Einzelgruppen, also ein dublettenfreier Ergebnisbestand.
Der Referenzmatch
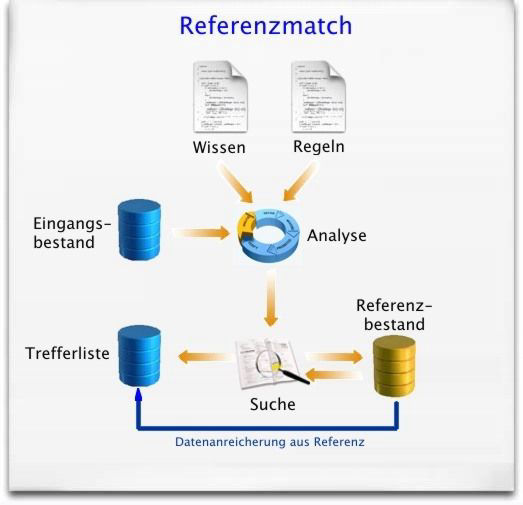
Unter einem Referenzmatch verstehen wir den Vergleich von zwei bzw. mehr Adressbeständen untereinander. Dabei werden neben den in jedem einzelnen Bestand enthaltenen Dubletten auch diejenigen Datensätze ermittelt, die im anderen Bestand ebenfalls vorhanden sind.
Der klassische Referenzmatch wird z. B. benötigt, wenn Sie Ihren eigenen Datenbestand zum Zwecke der Datenanreicherung bzw. des Datenimports gegen externe Adressen (z. B. Robinsonliste, Umzugsdatei, Neuadressen, Bestände mit Bonitätsinformationen, Nixies, etc.) abgleichen möchten.
Ein anderes Beispiel wäre der Vergleich von Adressen, die intern in unterschiedlichen Abteilungen und/oder Systemen gepflegt werden und zwischen denen keine Verbindungen bestehen.
Online-Demo
Probieren Sie es mit einer eigenen Adresse aus.
Die Online-Demo zeigt die Verfahren direkt im Browser. Fragen zu Produkten oder zum Unternehmen beantworten wir gerne persönlich.